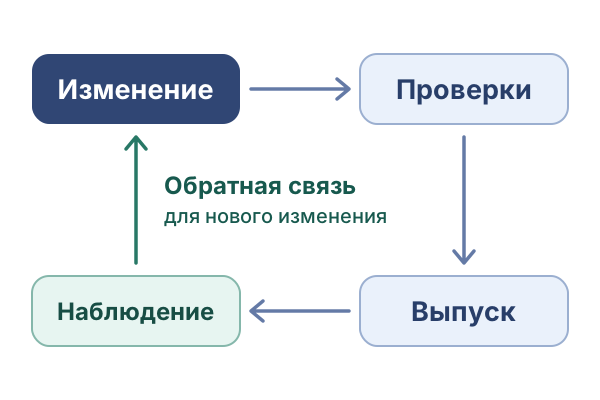
DevOps — это подход, при котором разработка и эксплуатация вместе отвечают за путь изменения от кода до работающего продукта. Вот исправление формы записи. Команда проверяет его автоматически, выпускает новую версию и смотрит, доходят ли заявки от пользователей. Сбой видно по результату. Если заявки перестали поступать, команда может остановить выпуск и восстановить работу. Короткая самооценка поможет вспомнить, какие из этих практик уже вам знакомы.
Что команда делает вместе?
Atlassian объясняет, что название DevOps соединяет development, «разработка», и operations, «эксплуатация». Разработчики меняют продукт, а специалисты по эксплуатации поддерживают его в среде, где им пользуются. Что их связывает? Обеим сторонам полезно знать, что меняется и как это скажется на работе продукта после выпуска. В определении AWS поэтому есть и культура совместной работы, и практики, и инструменты.
Задача простая. На сайте записи на занятия нужно добавить выбор времени с телефона, и разработчик меняет форму и пишет проверку для свободных мест. Тестировщик пробует записаться на маленьком экране. Специалист по эксплуатации предлагает выяснить, сколько отправок завершится успешно после выпуска. В небольшой команде часть этой работы может делать один человек.
Что должно получиться? Пользователь открывает список, выбирает свободное время, отправляет заявку и получает подтверждение. Если проверить каждый экран по отдельности, можно пропустить момент, когда нажатие кнопки не приводит к записи. Поэтому команда договаривается, как проверит всю цепочку ещё до того, как изменение увидят пользователи.
Человек в чате пишет «форма открывается», а коллега в это время пытается отправить запись с телефона. Подтверждения нет. Разработчик проверяет, что видит пользователь после нажатия кнопки, а сотрудник эксплуатации смотрит, дошла ли заявка. Их наблюдения дополняют друг друга и помогают понять, на каком шаге перестала работать запись.
Кому нужен результат? Владелец продукта по нему определяет, когда можно сообщить пользователям о новой функции, а разработчики видят, как она ведёт себя на реальных устройствах. Эксплуатации тоже нужна эта информация. Если известно, что изменилось и как продукт должен был себя вести, разобраться в сбое проще.
💡 Интересный факт
В 2009 году первые DevOpsDays прошли в Генте, Бельгия. В архиве организаторов сохранилась программа этой встречи. Они отводили время и на короткие выступления, и на обсуждения, темы которых участники предлагали сами.
Источник: официальный архив DevOpsDays, программа встречи в Генте.
Проверки, сборка и готовность версии
CI означает непрерывную интеграцию. Команда часто объединяет небольшие изменения с общей версией кода, а автоматические проверки показывают, собирается ли программа и работают ли нужные сценарии. Что называют сборкой? Так готовят файлы, которые потом можно установить или запустить. Получившуюся версию связывают с кодом и результатами тестов, чтобы её можно было узнать на следующем этапе.
Для начала возьмите два сценария. Форма принимает свободное время и отклоняет занятое. Эти проверки можно запускать и при дальнейших изменениях. Если одна перестанет проходить, разработчик увидит, какая часть записи сломалась, пока ещё помнит свою правку. Через несколько выпусков искать ту же причину было бы труднее, потому что код успел бы измениться в нескольких местах.
GitHub рассказывает, что его инженеры собирают и проверяют GitHub.com с помощью GitHub Actions. Они заметили повторяющиеся шаги. Общие сценарии вынесли отдельно, чтобы разные процессы могли их вызывать. Когда такой шаг нужно исправить, команда может обновить общий сценарий и использовать его в тех проектах, где проверка нужна.
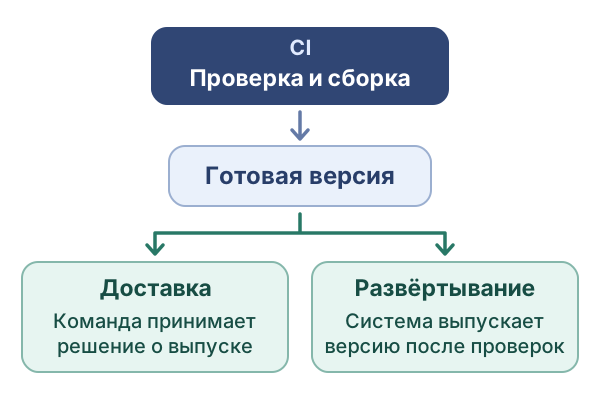
У CD две расшифровки. При непрерывной доставке, continuous delivery, проверенная версия готова к выпуску, который можно запустить по решению команды. При непрерывном развёртывании, continuous deployment, система сама меняет рабочую версию после прохождения необходимых проверок. AWS различает эти варианты по тому, нужен ли отдельный шаг для начала выпуска.
| Этап | Вопрос, на который отвечает |
|---|---|
| Интеграция | Можно ли объединить изменение с основной версией и проходят ли проверки? |
| Доставка | Готова ли известная версия к выпуску, когда команда примет решение? |
| Автоматическое развёртывание | Может ли система выпустить версию по согласованным правилам после проверок? |
Сколько проверок нужно? Новую подсказку легко перечитать, а прежний текст при необходимости вернуть. Изменение правил расчёта может затронуть уже сохранённый результат у пользователя. Команда выбирает проверки по тому, что может измениться после выпуска. В обоих случаях полезно знать, какую версию проверили и чем закончился конкретный запуск.
Конвейер остановился. Возможно, приложение перестало выполнять нужный сценарий, а возможно, недоступна сама тестовая среда. Отчёт с названием этапа и ссылкой на результат запуска поможет отличить одно от другого. Коллега сможет начать проверку с того же места и увидеть те же сведения, что и автор изменения.
Как связать проверку с конкретной версией
После сборки полезно сохранить её результат под однозначным обозначением. Тогда можно посмотреть, из какого изменения появился файл, какие проверки прошли и когда команда решила его выпускать. Если перед каждым выпуском программу собирают заново с другими настройками, становится труднее объяснить, почему одна и та же правка показала разный результат. Условия и зависимости можно записывать рядом с процессом сборки.
Для сайта с формой команде важна простая цепь событий. Исходное изменение принято, сборка готова, проверки прошли, та же сборка выбрана для выпуска. В журнале работы можно связать эти события. Если у команды есть отдельная проверочная среда, проверьте в ней именно ту версию, которая кандидатом пойдёт в рабочую среду. Тогда результаты проверки относятся к выбранной сборке, а различия конфигурации можно рассмотреть отдельно.
Хранить подряд каждую промежуточную версию для этого не требуется. Лучше определить, какие результаты тестов и какие выпуски нужно уметь найти позднее. При очередном выпуске проверьте, может ли коллега открыть запись и назвать версию без подсказки автора. Такой вопрос быстро выявляет слабые места документации.
Как выпустить изменение и вовремя заметить проблему?
С чего начать наблюдение? Посмотрите, получает ли пользователь подтверждение и доходит ли заявка. Команда может проверить это заранее в тестовой среде. После выпуска добавляются реальные устройства, нагрузка и внешние системы, которые влияют на работу формы. Поэтому полезно видеть и показатели самого сервиса, и итог для человека, который пытался записаться.
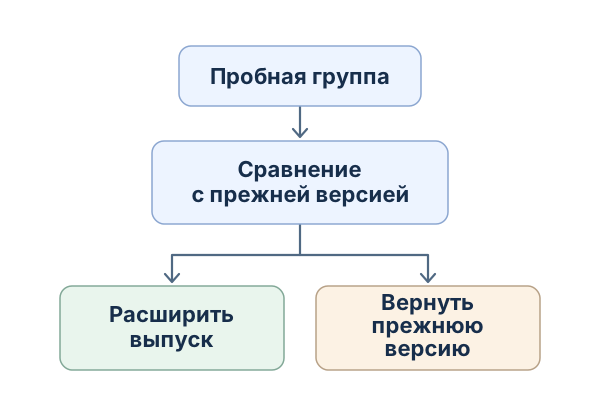
Выпуск можно начать с небольшой группы и сравнить её результаты с показателями остальных пользователей, которые в это время работают на прежней версии. Такой пример описан в инженерном блоге Netflix. Сравнение там автоматизировано. Можно следить за временем ответа или числом ошибок. Если показатели ухудшились, пробу можно остановить и выяснить причину.
Заранее договоритесь, кто остановит выпуск и что станет поводом. Для формы важна доля успешных отправлений. Посещения могут идти как раньше, даже если заявки перестали доходить. Когда новой версией пользуется мало людей, наблюдению может понадобиться больше времени. Иногда команда дополнительно проверяет нужное действие вручную и смотрит, получает ли подтверждение.
Инженер открывает журнал выпуска, а в чате уже спрашивают, можно ли вернуться к прежней версии. Где она? Если любой участник может её найти, команда быстрее займётся восстановлением. Когда прежняя форма заработает, можно проверить, в какой ситуации новая теряла заявку. Если запись о версии лежит только у одного коллеги, задержка начинается ещё до диагностики.
Когда возврат требует отдельной проверки
Возврат к предыдущей версии называют откатом. Что успела изменить новая версия? Если поменялась подсказка, обычно достаточно вернуть прежний текст на экране. Новая форма может успеть сохранить записи в другом виде, и после отката их всё равно нужно прочитать. Если меняется формат данных, обсуждение совместимости стоит провести до выпуска.
Большой переход можно разделить на выпуски. Сначала приложение учится понимать данные в старом и новом виде. Следующий выпуск меняет способ записи. Между ними команда успевает проверить, что приложение всё ещё читает данные, сохранённые раньше. Это пригодится, когда двум версиям нужно какое-то время работать рядом. Для правки обычного текста совместимость записей чаще всего проверять не приходится.
Как метрики, журналы и трассы дополняют друг друга
В документации OpenTelemetry метрики, журналы и трассы описаны как разные источники сведений о работе приложения. Представим, что после обновления формы запись проходит, но экран с подтверждением появляется с задержкой.
Метрика сводит измерения в показатель. Например, команда сравнивает время от отправки формы до подтверждения до и после выпуска. На графике видно, начался ли рост задержек сразу после обновления и сколько времени он сохранялся.
Журнал хранит записи об отдельных событиях с отметками времени. В нём может быть запись о том, что на отправку подтверждения сервису понадобилась повторная попытка. По времени можно проверить, появились ли такие записи в тот же час, когда выросла задержка.
Трасса показывает путь одной отправки и время на каждом этапе. Например, форма приняла запрос, запись сохранилась быстро, а большая часть ожидания пришлась на подтверждение. Если похожая трасса видна и у других медленных отправок, команда знает, с какого этапа начать проверку.
Что делает DevOps-инженер?
Обязанности зависят от компании. Где-то инженер отвечает за общий процесс сборки, где-то за рабочую среду и показатели, по которым заметен сбой. Он может поддерживать шаблоны и инструкции, которыми пользуются несколько команд. Разработчик продолжает работать над поведением приложения. Кто принимает решение о выпуске и кто будет на связи после него, участники определяют вместе.
| Задача | Что меняется для команды |
|---|---|
| Общий путь сборки и проверки | Есть известные шаги выпуска и понятные результаты проверки |
| Настройки среды в виде описания | Изменение можно проверить, повторить и связать с конкретной версией |
| Показатели после выпуска | Видно, что произошло с приложением и заметил ли проблему пользователь |
| Уточнение ответственности | Команда знает, кто ведёт выпуск, кто реагирует и кто сообщает о восстановлении |
Настройки можно описать в файлах. Инфраструктура как код, или IaC, позволяет хранить такое описание среды и видеть историю его изменений. Если люди вручную настраивают несколько сред, одна может незаметно разойтись с другой. Чтобы понять, какое изменение привело к разнице, нужна история версий. Как вести её для настроек, объясняет статья об управлении конфигурацией.
В контейнере программа работает с окружением, которое подготовили для запуска. Если таких экземпляров много, их запуском управляет система оркестрации. С чего начать небольшой команде? Попробуйте повторить сборку и найти уже проверенную версию. Когда это получается, проще понять, какие действия действительно облегчит новое средство и появятся ли у команды лишние ручные шаги.
Пусть инженер сначала посмотрит, что человек делает при каждом выпуске. Есть ли повторяющийся шаг с понятным результатом? Команда может начать со сборки после изменения кода и автоматически сообщать, удалась ли она. Когда коллеги увидят, сколько ручной работы ушло, им будет проще выбрать следующую задачу. Программы с практикой сборки и эксплуатации собраны в разделе курсов DevOps.
Как DevOps связан с SRE?
DevOps — подход к совместной работе разработки и эксплуатации. Команды договариваются, как проверять и выпускать изменения и по каким признакам судить, что сервис работает как задумано. Авторы руководства Google описывают SRE (Site Reliability Engineering) как инженерный способ воплотить эти принципы в работе над надёжностью. Для этого команда выбирает измеримый показатель и задаёт, какого значения хочет достичь.
Условный пример с сайтом, который принимает заявки. Для пользователя успешный результат — получить на экране подтверждение, что сайт принял заявку. Команда считает долю попыток отправки, после которых система показала подтверждение в течение пяти секунд. Она может поставить цель. За последние 30 дней хотя бы 99 % попыток должны завершиться таким подтверждением. Эту цель называют SLO (Service Level Objective), или целевым уровнем работы сервиса.
Если доля подтверждений опускается ниже цели, разработчики и специалисты по эксплуатации могут вместе выяснить, на каком шаге возникает задержка. Если заявки копятся в очереди, команда может в следующем выпуске ускорить их обработку и затем сравнить результат с целью.
Какие показатели показывают, что стало лучше?
Посмотрите на несколько выпусков подряд. По одному быстрому выпуску трудно судить, изменился ли процесс. В актуальном руководстве DORA пять метрик. Одни описывают темп поставки, другие показывают, как часто команда сталкивается с неудачами и внеплановой работой. Чтобы читать числа вместе, измеряйте один продукт и договоритесь, какие события отмечаете.
| Метрика | Что измеряют |
|---|---|
| Частота развёртываний | Как часто изменения попадают в рабочую среду |
| Время доставки изменения | Сколько прошло от записи изменения в системе контроля версий до развёртывания |
| Время восстановления после неудачного развёртывания | Через какое время восстановилась работа после выпуска, потребовавшего немедленного вмешательства |
| Доля неудачных развёртываний | Какая часть выпусков потребовала немедленного вмешательства |
| Доля внеплановых развёртываний для исправления | Какая часть выпусков состоялась вне плана из-за инцидента в рабочей среде |
Команда делит ежемесячный пакет на небольшие изменения. Частота выпусков может вырасти. Посмотрите также на долю неудач и время восстановления. Если появился ещё и поток внеплановых исправлений, команде полезно выяснить, какие сбои их вызывают. Если продукт остаётся устойчивым, рост частоты можно обсуждать вместе с тем, как пользователи получают изменения.
Заявка дошла? Этот результат помогает увидеть, сказался ли выпуск на людях, а показатели DORA описывают, как команда доставила само изменение. На общем разборе пригодятся оба набора данных. Для этого нужно знать, откуда пришли сведения и какое событие запускает каждый отсчёт.
Больше десяти развёртываний в день — так команда Flickr описывала свою работу на конференции Velocity. Разработка и эксплуатация смотрели на общие показатели и заранее обсуждали, что будет после выпуска. Это опыт одного сервиса с его нагрузкой и устройством команды. Для своего продукта можно проверить, где задерживается небольшое изменение и сколько времени занимает восстановление после сбоя.
Разбор ручного выпуска
Вспомните последний выпуск. Кто первым узнал об изменении? Где лежал файл, который установили, и кто проверил результат? Такие вопросы показывают, где людям пришлось ждать. Небольшая команда может выбрать одно повторяющееся затруднение и попробовать его убрать. На следующем выпуске станет видно, что изменилось в работе.
- Назовите готовую версиюСвяжите файлы выпуска с изменениями кода и результатами проверки, чтобы любой участник нашёл их по одному событию.
- Проверьте ключевое действиеВыберите один значимый сценарий. Для сайта записи проверьте, что заявка доходит и отображается подтверждение.
- Запишите результат выпускаПосле изменения отметьте, что увидела команда, на что пожаловались пользователи и какое улучшение нужно следующим.
Передайте выпуск коллеге. Пусть он получит список источников и положенные полномочия. Сможет ли человек, который обычно этим не занимается, найти готовую версию, узнать, кто принимает решение, и понять, куда сообщить о сбое? Если часть процесса приходится пересказывать голосом, запишите то, без чего коллеге было труднее всего продолжить.
Возьмите знакомое приложение. Как вы проверите одно изменение и узнаете, что выпущена именно эта версия? Заранее назовите признак успешного результата. Вопросы на карточке охватывают проверку и доставку, настройки среды, наблюдаемость и сотрудничество. Ответы можно обсудить с коллегой и решить, какой из навыков потренировать на следующем изменении.
Вывод
DevOps связывает изменение, проверку, выпуск и наблюдение. Какая версия работает? По какому признаку команда поймёт, что выпуск пора остановить? Если у коллег уже есть ответы на эти вопросы, в самооценке можно заметить следующий шаг — практику, которая пока держится на ручной работе.