SQL — язык для работы с данными в таблицах. Название обычно раскрывают как Structured Query Language, то есть язык структурированных запросов. На нём можно попросить показать нужные записи, посчитать итоги, а при наличии разрешений и изменить сами данные. Например, из каталога библиотеки можно получить названия книг, изданных с 2020 года. На этом примере разберём, как устроен запрос. В тесте ниже есть вопросы по основам SQL и другим навыкам работы с данными.
Для чего нужен язык запросов?
SQL даёт приложению или человеку способ обратиться к данным. Библиотекарь хочет список свежих изданий. Аналитик подсчитывает выдачи по месяцам. Разработчик сохраняет новую запись, когда читатель берёт книгу. Во всех трёх случаях система получает инструкцию на одном языке, хотя задачи у неё разные.
Вы просите знакомого принести из библиотеки что-нибудь свежее. Он возвращается с потрёпанной книгой и парирует, что вчера её только поставили на полку. Для запроса сперва придётся выбрать, что означает «свежее». Если речь про год издания, условие должно смотреть на год. Для даты поступления в библиотеку понадобится другой столбец.
База данных хранит сведения. Система управления базами данных, или СУБД, читает их и выполняет команды. SQL задаёт, что с ними сделать. Запрос остаётся текстом до тех пор, пока его не передадут подходящей системе. Окно, где вы пишете запрос, может принадлежать программе для работы с базой или приложению, которое само отправляет запросы.
| Понятие | Что делает в примере с библиотекой |
|---|---|
| База данных | Хранит списки книг и выдач |
| СУБД | Находит записи, применяет условия, возвращает результат |
| Запрос SQL | Определяет, какие сведения нужны или какую операцию выполнить |
| Клиент | Передаёт текст запроса и показывает табличный результат |
SQL называют декларативным языком. Вы описываете результат, например «названия книг начиная с выбранного года». Согласно документации PostgreSQL о пути запроса, система разбирает команду и выбирает план выполнения. Допустимых способов может быть несколько. Для небольшой таблицы можно прочитать все строки. Если есть подходящий индекс, система может сначала поискать нужные значения по нему. Индекс в базе помогает найти записи примерно так, как указатель в конце книги помогает открыть нужную страницу.
Для разных задач есть разные команды. SELECT возвращает выбранные данные. INSERT добавляет записи, UPDATE меняет значения в имеющихся строках, DELETE удаляет строки. Команда CREATE TABLE описывает структуру новой таблицы. Для первой практики достаточно SELECT: его результат можно посмотреть и сравнить с исходной таблицей. Во всех запросах ниже данные читаются.
💡 Интересный факт
В 1974 году Дональд Чемберлин и Рэймонд Бойс из IBM представили язык под именем SEQUEL, Structured English Query Language. По словам Чемберлина, это название оказалось чужим товарным знаком. Из раннего написания убрали гласные, и остались буквы SQL.
Источники: доклад Чемберлина и Бойса на конференции SIGFIDET и интервью Чемберлина для Музея компьютерной истории.
Как таблицы отличают книгу от выдачи?
Таблица собирает записи одного вида. Строка в каталоге описывает книгу, а строка в журнале выдач описывает случай, когда книгу взяли. Столбец хранит один признак, например название или год. В простой реляционной схеме таблицы связаны общими значениями. Связь задаётся правилом: запись о выдаче хранит номер книги из каталога.
Условный пример. В таблице books три книги. В столбце id записан уникальный номер, в title название, в year год издания. Две разные записи могут иметь одинаковый год. В настоящем каталоге могут совпасть и названия. Поэтому для связи с журналом выбирают уникальный ключ, который однозначно указывает на запись. В этом примере первичным ключом каталога служит id.
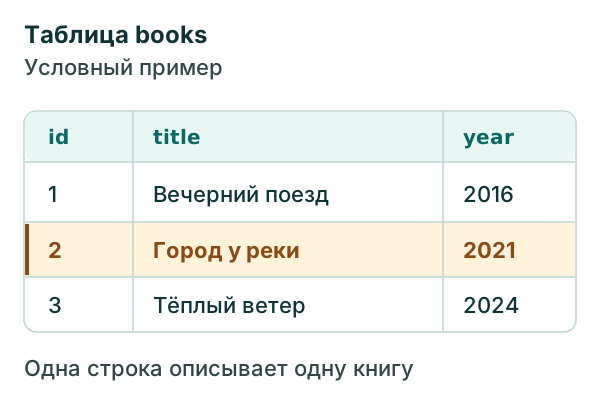
| id | title | year |
|---|---|---|
| 1 | Вечерний поезд | 2016 |
| 2 | Город у реки | 2021 |
| 3 | Тёплый ветер | 2024 |
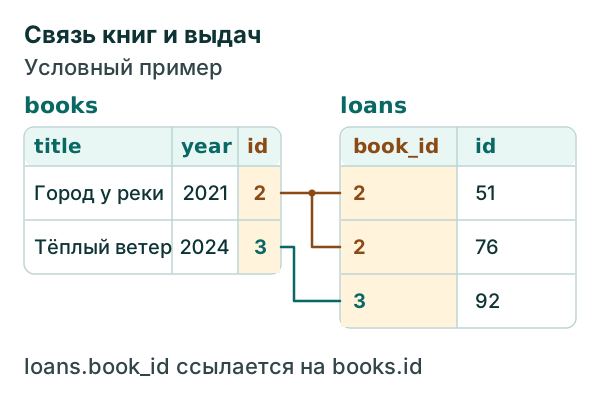
В журнале loans столбец id относится к выдаче, а book_id указывает на книгу. Для одной книги журнал может хранить несколько выдач с разными номерами. В действующем приложении такую связь можно закрепить внешним ключом. При включённой проверке ограничений СУБД следит, чтобы указанный номер книги был в каталоге. В примере ниже это правило показано данными.
| id выдачи | book_id |
|---|---|
| 51 | 2 |
| 76 | 2 |
| 92 | 3 |
У стойки читатель просит «ту самую книгу про реку», а библиотекарь находит её карточку и сверяет номер. Пока они разговаривают, за спиной в очереди уже предлагают назвать любую реку, лишь бы очередь пошла быстрее. В таблице номер помогает различить книги сразу. Он также позволяет найти обе записи о выдаче, даже если заголовок книги в каталоге когда-нибудь поправят.
Как прочитать SELECT с условием?
Запрос SELECT возвращает таблицу с выбранными полями. FROM указывает, откуда взять строки, а WHERE пропускает строки, у которых условие истинно. Если в каталоге нужны заголовки изданий начиная с 2020 года, запишем условие для year. Знак больше или равно включает саму границу.
SELECT title
FROM books
WHERE year >= 2020;
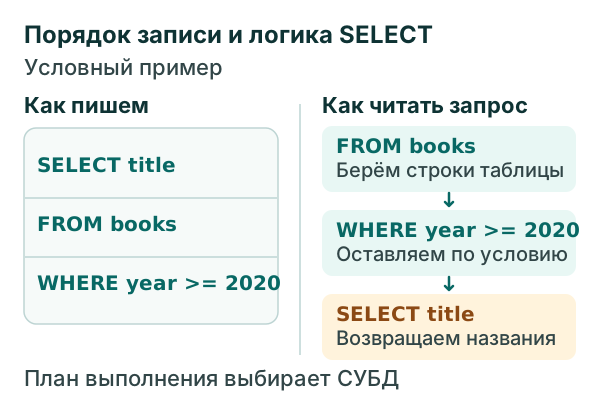
По документации SQLite для SELECT, результат можно мысленно получить в несколько этапов. Сначала FROM подаёт строки таблицы. После условия остаются записи 2021 и 2024 годов. Затем SELECT берёт из них только значения title. Получатся «Город у реки» и «Тёплый ветер». Такой разбор помогает понять смысл запроса. СУБД вправе выбрать другой способ исполнения, который даёт тот же результат.
В запросе задан состав результата, а порядок строк отдельно задаёт ORDER BY. Если хочется получить новые книги первыми, после WHERE добавляют ORDER BY year DESC, id ASC. Сначала результаты идут по убыванию года. ASC использует возрастание id среди книг с равным годом. Этот дополнительный ключ особенно полезен, когда после сортировки нужно взять только несколько строк.
Условия на текст записываются похожим способом. SQL отличает имя столбца от значения. В запросе ниже title обозначает столбец, а текст между одинарными кавычками обозначает конкретное название. Результат содержит номер и год одной книги из примера.
SELECT id, year
FROM books
WHERE title = 'Тёплый ветер';
Запятая между id и year говорит вывести два столбца по порядку. Чтобы увидеть все поля, можно написать SELECT * в коротком просмотре незнакомой таблицы. В запросе для регулярного отчёта перечислите нужные столбцы явно. Тогда состав результата понятен по тексту даже после добавления служебных полей в таблицу.
Эти короткие запросы обращаются к уже существующему каталогу books. Ниже есть вариант, который включает данные прямо в запрос. Синтаксис из трёх строк при этом остаётся тем же. Отступы помогают заметить, где меняется смысл инструкции: источник, условие и состав результата.
Что меняется, когда таблиц две?
JOIN сопоставляет строки по условию ON. Чтобы узнать, какую книгу брали при конкретной выдаче, к журналу можно присоединить каталог по равенству book_id и id. Две выдачи книги с номером 2 образуют две пары с одной и той же строкой каталога.
SELECT b.title, l.id AS loan_id
FROM books AS b
INNER JOIN loans AS l ON b.id = l.book_id
ORDER BY l.id;
AS задаёт короткие имена для таблиц и подписи для столбцов. Здесь b обозначает books, а l обозначает loans. Так видно, какой именно id стоит в условии. Запрос с INNER JOIN найдёт три пары: две для «Города у реки» и одну для «Тёплого ветра». «Вечерний поезд» отсутствует, потому что для него в журнале пока нет выдач.
Перед соединением определите, какой объект должна описывать строка результата. У списка выдач одна строка относится к одному событию, поэтому заголовок книги может встретиться несколько раз. На стойке это привычно: в карточке книги один заголовок, в журнале он связан с каждой записью о выдаче. Удаление совпадающих заголовков лишило бы такой отчёт части информации.
Если нужен список всех книг с возможными выдачами, поставьте books слева и замените INNER JOIN на LEFT JOIN. В строке «Вечернего поезда» значение loan_id будет NULL. Здесь NULL показывает, что СУБД сохранила левую строку и не нашла записи, откуда взять значение справа. Значение NULL в таблице может означать и неизвестное свойство существующей записи. Смысл приходится выяснять по данным и условию запроса.
Левое соединение даёт четыре строки, потому что две выдачи второй книги по-прежнему образуют две пары. После замены соединения проверьте число строк вручную на маленьком примере. Так легче распознать проблему, когда в большой таблице одно поле соединения ошибочно принимают за уникальное. В условии ON лучше назвать точные ключи, чем полагаться на привычный заголовок или случайное совпадение названий.
От списка выдач к подсчёту
Чтобы получить итог по каждой книге, соберите связанные строки в группы. Выбор полей GROUP BY определяет, что станет одной строкой итога. Название может совпасть у двух книг, поэтому при группировке по книгам важно оставить id. COUNT подсчитает имеющиеся номера выдач внутри каждой группы.
SELECT b.title, COUNT(l.id) AS issue_count
FROM books AS b
LEFT JOIN loans AS l ON b.id = l.book_id
GROUP BY b.id, b.title
ORDER BY b.id;
| Книга | issue_count |
|---|---|
| Вечерний поезд | 0 |
| Город у реки | 2 |
| Тёплый ветер | 1 |
В документации PostgreSQL указано, что COUNT со столбцом считает значения, которые отличаются от NULL. Поэтому книга без пары получает ноль, хотя LEFT JOIN сохранил её строку. При COUNT(*) учитывается каждая строка результата соединения. Для той же книги получилась бы единица. Выбор функции зависит от вопроса: сколько строк после соединения или сколько найдено выдач.
Условие WHERE проверяет строки до группировки. С его помощью можно оставить только книги начиная с определённого года. Когда нужны только книги с двумя выдачами и больше, проверять надо итог группы. Условие HAVING COUNT(l.id) >= 2 добавляют между GROUP BY и ORDER BY. Из библиотечной таблицы останется «Город у реки».
На отчёте по тысячам строк легко пропустить ошибку, если итог выглядит правдоподобно. Начните с одной книги, для которой число выдач можно пересчитать глазами. Сверьте три промежуточных результата: строки каталога, пары после JOIN и итог для этой группы. Такая проверка показывает, в каком месте изменилось число, вместо того чтобы искать ошибку во всём запросе.
В отчётах бывает нужен общий счётчик по нескольким изданиям одного произведения. Тогда сначала выясняют, есть ли в каталоге отдельный ключ произведения. Если он есть, отчёт группируют по нему. Заголовок полезен для чтения результата, а правило объединения определяют нужной единицей учёта.
Где встречаются такие запросы?
Примеры из документации показывают одни и те же операции на разных данных. В каталоге фильтруют записи по типу, в метеорологическом наборе присоединяют сведения о городе, а в текстовом корпусе подсчитывают строки. Читать их проще, когда сначала понятно, что именно записано в каждой таблице.
В учебнике PostgreSQL таблица weather хранит наблюдения погоды, а таблица cities содержит координаты города. В приведённых данных две записи относятся к Сан-Франциско, одна к Хейворду. В таблице координат из примера есть только Сан-Франциско. Согласно этому учебнику, LEFT JOIN сохраняет наблюдение для Хейворда и оставляет поле координат без значения. Это пригодится для отчёта, в котором нужно увидеть наблюдения со справочником и сразу найти пробелы в самом справочнике.
В справке SQLite показано, как посмотреть имена таблиц. Специальная таблица sqlite_schema хранит описание объектов базы. Там есть имя объекта и его тип. При выборке имён с условием type = 'table' результатом будет перечень таблиц в открытом файле, в том числе служебных, если они присутствуют. Этот приём решает вопрос «с какими таблицами имею дело» прежде, чем читатель напишет запрос к их данным.
Согласно официальному учебнику Python по модулю sqlite3, сортировку можно увидеть на таблице фильмов «Монти Пайтон». В примере выбирают год и название фильма, затем сортируют по году. Так «Житие Брайана» 1979 года оказывается после фильма 1975 года и перед фильмом 1982 года. Результат можно проверить по нескольким соседним строкам, даже не зная, как клиент хранит их после запроса.
В документации Google Cloud указан открытый индекс слов произведений Шекспира для BigQuery. В примере службы запрос считает все строки набора и отдельно строки корпуса «Гамлета». Это число записей индекса. Чтобы ответить, сколько всего раз встретились слова, потребовалось бы суммировать записанные в индексе частоты.
- Из окна клиента, если человек разбирает данные вручную.
- Из отчёта, который обращается к базе при обновлении показателей.
- Из программы, которая показывает на экране выбранные записи.
SQLite, PostgreSQL и различия в командах
SQLite и PostgreSQL понимают SQL и имеют свою программу исполнения. По документации SQLite, её движок работает внутри приложения и может хранить базу в обычном файле. PostgreSQL устроен как клиент и сервер. Клиент отправляет команду серверу PostgreSQL, сервер выполняет её и возвращает результат. Общее название языка ещё оставляет место различиям в командах, типах и встроенных функциях.
Основные части SELECT можно узнать в разных системах. Международный стандарт ISO/IEC 9075 описывает язык и его части. Системы расширяют его под свои задачи. Например, ограничить число результатов в SQLite и PostgreSQL можно с помощью LIMIT, а в SQL Server для этого предусмотрен TOP. Для подключения к другой базе сначала выясните название системы и какие варианты синтаксиса она поддерживает.
Некоторые отличия обнаруживаются даже в знакомом запросе. Если отсортировать записи по нескольким полям, то строки с одинаковыми значениями всё ещё могут поменяться местами. Если среди полей есть неизвестные значения, политика их сортировки может различаться. Для отчёта «последние записи» используют явный порядок и добавляют уникальный ключ, если время у двух записей совпало. Так легче проверить, какой результат ожидался и какие строки попали под ограничение.
| Задача | Что проверить |
|---|---|
| Вывести выбранные столбцы | Названия таблицы и полей в своей базе |
| Взять часть результата | Оператор ограничения и порядок через ORDER BY |
| Сравнить даты или обработать время | Формат хранения и функции конкретной СУБД |
| Получить итог по группам | Все обычные столбцы участвуют в группировке или определяются ею |
Перед переносом отчёта прогоните короткую выборку на нескольких известных записях. Проверьте, как обработаны пустые значения и как отсортированы результаты. Когда ответ расходится с ожиданием, сравнение известных примеров подскажет, повлияли ли данные, синтаксис или условия запроса.
Как запустить пример с нуля?
Для первой попытки можно задать три строки книг прямо внутри запроса. Конструкция WITH даёт набору временное имя books. VALUES задаёт сами значения. Имена у временных столбцов перечислены после books. Такой запрос для SQLite или PostgreSQL не создаёт постоянную таблицу. Внизу него стоит уже знакомая выборка.
WITH books(id, title, year) AS (
  VALUES
    (1, 'Вечерний поезд', 2016),
    (2, 'Город у реки', 2021),
    (3, 'Тёплый ветер', 2024)
)
SELECT title
FROM books
WHERE year >= 2020
ORDER BY year, id;
Подойдёт окно для выполнения SQL в учебной SQLite или PostgreSQL. Выберите целиком текст из блока, включая WITH. В результате сначала появится «Город у реки», затем «Тёплый ветер». Место строк друг относительно друга теперь задаёт сортировка. Точка с запятой обозначает конец инструкции.
- Измените годПоставьте границу 2024 и прочитайте название единственной книги, которая проходит условие.
- Добавьте полеУкажите через запятую year после title в строке SELECT. Год появится рядом с названием.
- Поменяйте порядокВерните начальную границу 2020 и добавьте DESC после year в ORDER BY. Книга 2024 года окажется первой.
После каждой правки угадайте результат перед запуском. Это полезнее механической замены слова: вы связываете новую строку запроса с конкретным изменением ответа. Если хочется закрепить выборки и соединения последовательными заданиями, есть раздел курсов по SQL с нуля.
Частые ошибки в первой выборке
Запрос может выполниться успешно и вернуть пустой ответ. В таком случае посмотрите на исходную таблицу и прочитайте условие ещё раз. Например, фильтр по году позже самого нового издания оставит ноль строк. Пустой результат ожидаем. Ошибка синтаксиса обычно сопровождается сообщением СУБД, и её полезно разбирать отдельно.
Проверяйте условие на одной конкретной записи. Если по замыслу подходит и книга граничного года, используйте сравнение с равенством. Если у записи год отсутствует, сравнение с числом не выберет такую строку. Согласно документации PostgreSQL, пустое значение проверяют через IS NULL. Число 0 и пустая строка могут храниться как обычные значения, поэтому проверять их надо своими условиями.
- Нужны записи ровно за один год или начиная с него?
- В ответе все книги или только книги с выдачами?
- Порядок важен для читателя или для следующей части запроса?
В отчёте после LEFT JOIN иногда хотят сохранить все книги и показать только выдачи выбранного периода. Если столбец даты из правой таблицы поставить в WHERE, строки без выдач обычно отпадут: условие с NULL не будет истинным. Если надо сохранить такие книги, критерий для правой строки можно добавить к условию ON. Тогда он определит, какие выдачи образуют пары, а книга без подходящей пары всё ещё останется в ответе.
Неизвестное имя столбца иногда оказывается опечаткой. Возьмите описание таблицы, сверьте название и его таблицу, особенно если в двух источниках есть поле id. Разные короткие имена b.id и l.id избавляют от вопроса, чей номер окажется в ответе. Смысл проверки тот же, что при чтении этикетки: у двух чисел могут совпасть цифры, но назначение у каждого своё.
Вывод
Сформулируйте вопрос к библиотеке и решите, что должна обозначать одна строка ответа. Для списка книг выберите столбцы из каталога и задайте условие. Для списка выдач присоедините журнал. Когда нужен итог, проверьте группировку и счётчик на книге с известным числом выдач. На уровне Junior в тесте можно потренироваться в выборе команд SELECT и WHERE и вспомнить, чем задают сортировку.