Нейросеть — это математическая модель из связанных вычислительных элементов, параметры которой подбирают при обучении на данных. Она преобразует входные числа в результат: класс изображения, прогноз, перевод или новый текст. Название связано с биологическими нейронами, но в компьютере работают вычисления. Чтобы понять устройство сети, разберём слои, обучение и три применения. Затем можно проверить себя в тесте с вопросами об обучении с учителем, эпохе, функции активации, обратном распространении ошибки и переобучении.
Что находится внутри искусственной нейронной сети?
Слово «нейросеть» образовано от сочетания «нейронная сеть». Когда спрашивают «нейросеть это что», часто имеют в виду чат или генератор картинок. Однако модель устроена глубже пользовательского окна. На вход поступают числовые представления данных, затем выполняется последовательность вычислений и получается выход.
Текст, звук и изображение нужно представить числами. У картинки это могут быть значения пикселей, у текста последовательность токенов и их числовые представления. Формат зависит от модели и задачи, поэтому одной универсальной формы входа для всех сетей нет.
В учебном курсе Google по машинному обучению узлы объясняются через взвешенную сумму входов и смещение. Вес определяет вклад соответствующего входного значения. Смещение добавляется к сумме, а функция активации преобразует полученное значение.
Биологическое название помогает рассказать историю идеи, а устройство современной модели описывается математикой: искусственный нейрон обрабатывает числа, в нём нет живой клетки. Для понимания работы удобнее следить за числами и преобразованиями, чем представлять маленьких собеседников внутри компьютера.
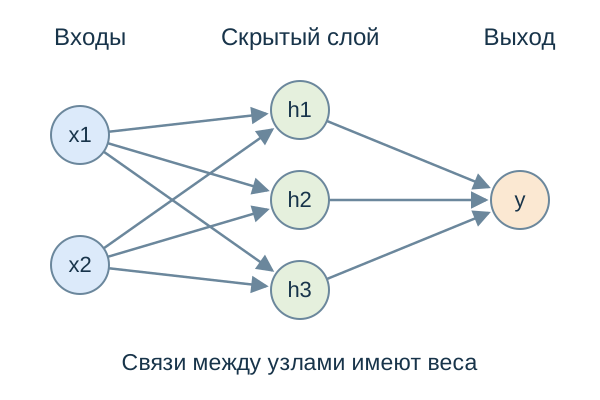
Условный пример одного узла: входы равны 2 и 1, их веса 0,5 и 1, смещение равно −1. Сначала считаем 2 × 0,5 + 1 × 1 − 1 = 1. Для функции ReLU положительное значение сохраняется, а отрицательное заменяется нулём; здесь выход равен 1.
В примере веса заданы заранее, чтобы было видно вычисление; при обучении их подбирает алгоритм, меняя значения для решения поставленной задачи. Несколько узлов объединяют в слои, и результат одного слоя становится материалом для следующего преобразования.
| Термин | Что он обозначает |
|---|---|
| Вход | Данные, по которым нужно получить результат |
| Вес | Параметр, влияющий на вклад входа в вычисление |
| Смещение | Дополнительный обучаемый параметр в сумме |
| Активация | Преобразование вычисленного значения |
| Скрытый слой | Промежуточное преобразование между входом и выходом |
| Выход | Числа, которые интерпретируют в соответствии с задачей |
Количество слоёв и способ связей относятся к архитектуре, а параметры описывают конкретное состояние модели после настройки на выбранном обучающем материале. Две сети одной архитектуры могут быть обучены на разных материалах и вести себя по-разному.
Как модель обучается на примерах?
Рассмотрим обучение с учителем: для примера известен целевой ответ. Модель выдаёт предсказание, его сравнивают с целью и вычисляют функцию потерь. Эта функция численно описывает, насколько предсказание расходится с требуемым результатом.
Обратное распространение позволяет вычислить градиенты, то есть чувствительность потерь к параметрам. На их основе оптимизатор изменяет параметры. Согласно материалам Google об обучении нейросетей, этот механизм делает возможной настройку многослойных моделей методом градиентного спуска.
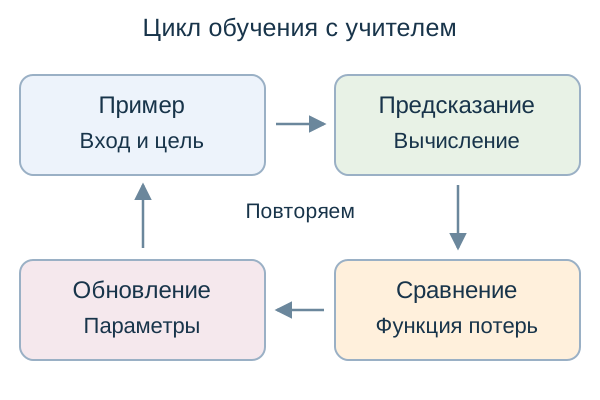
Данные обычно обрабатывают порциями. Один проход по обучающему набору называют эпохой, а для настройки может понадобиться несколько проходов. Число эпох выбирают вместе с другими условиями обучения, наблюдая за качеством.
Помимо обучения с учителем существуют другие подходы. При самоконтролируемом обучении часть задания формируют из самих данных, например предсказывают скрытый или следующий фрагмент. Обучение с подкреплением использует оценки действий через награду; конкретный способ зависит от задачи.
Важен не только объём. Ошибочные подписи, однообразные примеры и случайные связи могут исказить результат. Если в данных яблоки всегда сняты на одном фоне, модель способна использовать фон как удобную подсказку вместо нужных признаков объекта.
Представьте лиса, которому показывали яблоки только на белой тарелке: у дерева он ищет прежде всего тарелку. Разнообразие условий помогает проверять, какие признаки действительно полезны для задачи; история с лисом иллюстрирует зависимость от примеров, не описывая поведение конкретной системы.
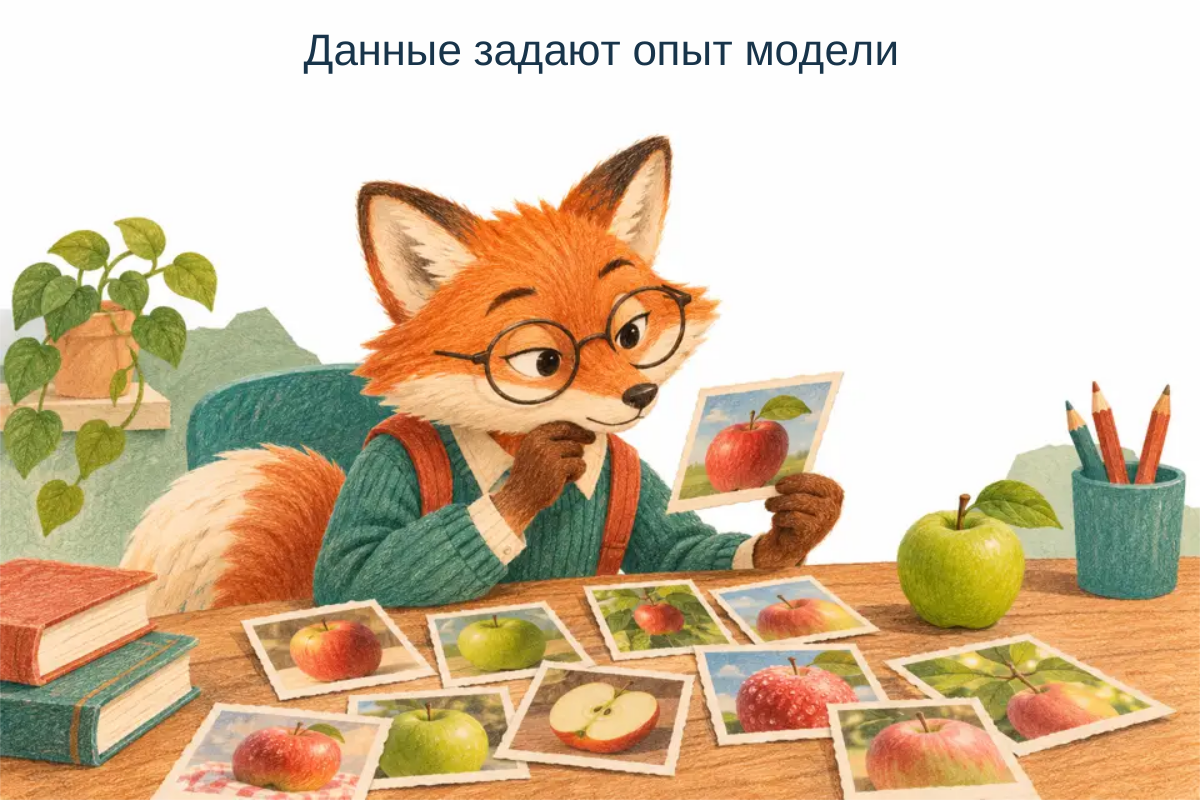
Подготовка данных включает проверку состава, разметки и соответствия будущей задаче. При распознавании предметов важно, в каких условиях их будут снимать. Для текста имеют значение язык, жанр и содержание, с которыми системе предстоит работать.
Тестовый набор отделяют от материала, на котором подбирают параметры, поскольку он нужен для итоговой оценки на новых примерах после завершения разработки. Во время разработки также используют проверочные данные для настройки решений, сохраняя независимость итоговой проверки.
Модель и другие методы решения задач
Искусственный интеллект — более широкая область задач и методов. Машинное обучение связано с построением моделей по данным, а искусственные нейронные сети составляют одно из его семейств. Чат с нейросетью относится к теме ИИ; при этом в области искусственного интеллекта существуют и другие методы.
Есть модели другого устройства: например, деревья решений. Выбор метода зависит от данных, требований к скорости, качеству и объяснимости. Для небольшой таблицы признаков сложная нейросеть может оказаться избыточной, хотя для других задач многослойные модели полезны.
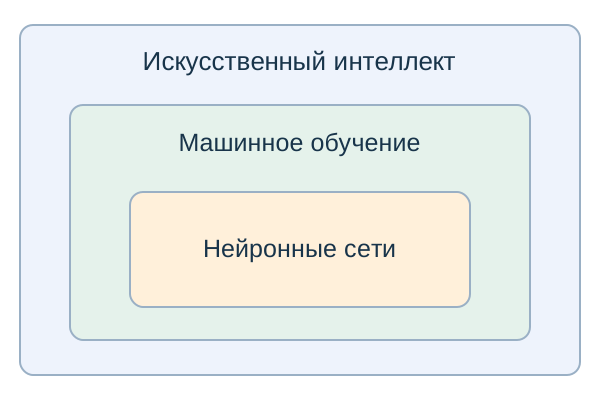
Глубокое обучение связано с многослойными нейронными сетями, которые строят последовательные представления данных. Слово «глубокое» относится к устройству преобразований, поэтому его используют для описания модели с несколькими уровнями, без оценки глубины размышления или человеческой мудрости.
Архитектуры тоже различаются. Полносвязные слои соединяют каждый входной элемент с узлами следующего слоя. Свёрточные сети используют локальные преобразования, полезные для изображений, а рекуррентные обрабатывают последовательности с переносом состояния между шагами.
Трансформеры используют механизм внимания, который учитывает связи между элементами представления. В материалах Google о языковых моделях внимание объясняется через значимость частей контекста друг для друга. Архитектура применяется не только к привычному окну переписки.
| Вопрос | Какой уровень вы обсуждаете |
|---|---|
| Как соединены вычисления? | Архитектура |
| Какие параметры получились? | Обученная модель |
| Как пользователь задаёт вопрос? | Интерфейс продукта |
| Откуда пришли найденные документы? | Подключённый поиск или база материалов |
| Кто выполнил точный расчёт? | Модель или отдельный вычислительный инструмент в системе |
Один сервис может объединять несколько компонентов: модель, поиск, хранилище, обработчик файлов и калькулятор. Поэтому свойства отдельной сети нужно отличать от возможностей продукта. Наличие поиска определяется устройством сервиса, а не самим словом «нейросеть».
Три применения: цифры, перевод и белки
Нейросети не ограничиваются генерацией текста и картинок. Одни модели выбирают класс, другие предсказывают значение или строят новую последовательность. Рассмотрим три опубликованных применения, чтобы у каждого была ясная задача и понятный результат.
MNIST: распознавание рукописных цифр
Согласно документации Keras, набор MNIST содержит 60 тысяч обучающих и 10 тысяч тестовых изображений цифр. Картинки имеют размер 28 × 28 пикселей в оттенках серого, а метки соответствуют цифрам от 0 до 9. Размер относится именно к этому набору.
Вход содержит 784 значения яркости: 28 × 28 = 784. Задача классификатора состоит в выборе цифры по изображению, а качество можно проверить по известным меткам. Так видна разница между входной картинкой и целевым ответом.
Набор используют для знакомства с машинным обучением. Успех на нём нужно рассматривать в границах этой задачи: иной почерк, формат кадра или качество съёмки меняют условия. Для промышленного распознавания потребуются данные и проверка под соответствующий сценарий.
GNMT: машинный перевод
Согласно публикации Google Research о системе GNMT, перевод рассматривает целое входное предложение как единицу. Эта работа о нейронном машинном переводе, опубликованная в 2016 году, показывает задачу преобразования одной последовательности в другую с сохранением смысла исходного высказывания.
На входе текст исходного языка, на выходе текст перевода. Для оценки нужно учитывать сохранение смысла, грамматику и контекст. Правильность здесь сложнее свести к одной метке, потому что допустимы разные формулировки.
Этот пример относится к описанной работе, а не к утверждению о нынешнем устройстве всех переводчиков. Современный продукт может использовать другие компоненты. Важен сам тип задачи: модель строит последовательность с учётом исходного текста.
AlphaFold: пространственная структура белка
В исследовании Джона Джампера и соавторов в Nature описана система AlphaFold для предсказания структуры белков. Публикация показывает применение нейросетевой модели к научной задаче. Результатом становится пространственное представление структуры, которое оценивают специальными методами.
Здесь входные сведения о белке преобразуются в предсказание его устройства. Работа содержит и ограничения точности, зависящие от условий задачи. Это исследовательский инструмент, поэтому из примера не выводят медицинские рекомендации для отдельного человека.
Три применения различаются входом, выходом и оценкой. В цифрах нужен класс, в переводе связный текст с сохранённым смыслом, в исследовании белка пространственная модель. Слово «нейросеть» объединяет способ построения вычислений, но не делает задачи одинаковыми.
- Что подают на вход и в каком представлении?
- Какой результат должна построить модель?
- По каким данным и признакам проверяют качество?
Почему сеть может ошибаться?
Причины зависят от задачи: данные могут быть неполными, разметка ошибочной, а реальные условия отличаться от обучающих по составу объектов, качеству материала и другим признакам. Модель также может быть недостаточно подходящей для нужного преобразования или плохо настроенной.
Переобучение означает, что модель хорошо подстроилась под обучающий материал, но плохо работает на новых данных. Этот случай разбирается в курсе Google через сравнение качества на разных наборах. Он показывает, зачем проверка отделена от подбора параметров.
Недообученная модель, напротив, не справляется достаточно хорошо даже с обучающими примерами. Причиной могут быть неподходящие признаки, недостаточная настройка или ограниченность выбранной модели. Размер модели не решает всё.
| Наблюдение | Какой вопрос нужно проверить |
|---|---|
| Хорошо на обучении, заметно хуже на новых примерах | Нет ли переобучения или отличия условий? |
| Плохо на обоих наборах | Подходят ли данные, модель и процедура обучения? |
| Качество падает после запуска | Не изменились ли реальные данные и сценарии? |
| Ответ выглядит убедительно, но источник не находится | Подтверждено ли конкретное утверждение? |
Для генеративного текста есть отдельная трудность. Языковая модель строит продолжение с учётом контекста и изученных закономерностей. Связность фразы и наличие фактического подтверждения оцениваются разными способами.
Представьте ответ с названием книги, автором и аккуратным годом издания: всё выглядит так, будто библиотекарь уже поставил печать. Вы начинаете искать книгу, а карточки нет. Такой эпизод показывает, почему конкретные библиографические сведения проверяют по каталогу или издателю.
Число, похожее на вероятность, тоже требует понимания. Оценка класса зависит от модели и условий её проверки. Нельзя читать любой высокий показатель как универсальную меру достоверности всего ответа или качества системы в другой задаче.
Как пользоваться моделью осмысленно?
Сначала определите действие: сократить текст, выделить пункты, создать варианты или объяснить термин. Затем задайте нужный материал и форму результата. Ясная задача помогает заметить, где ответ соответствует запросу и что нужно доработать.
Для первой пробы возьмите открытый, нечувствительный текст, который вы можете проверить сами. Например, попросите выделить мысли из собственного короткого абзаца и сохранить его смысл. Так вы увидите пропуски и добавления без сложной проверки неизвестной темы.
- Опишите действиеУкажите, что получить: краткий пересказ, список вопросов, варианты структуры или другое преобразование.
- Дайте контекстНазовите аудиторию, исходный материал и нужный формат. Передавайте только сведения, разрешённые для выбранного сервиса.
- Сверьте результатПроверьте смысл, факты и соблюдение условий. Для важных утверждений откройте соответствующий первоисточник.
Если хотите попробовать диалоговый формат, посмотрите раздел AI-чат-ботов. Перед использованием уточните возможности продукта, правила обработки данных и доступные инструменты. Чувствительные рабочие материалы требуют согласованного режима доступа.
Запрос в диалоге обычно становится частью входного контекста. Подстройка ответа к предыдущим репликам отличается от обучения параметров модели. Правила дальнейшего использования сообщений зависят от сервиса и его настроек, поэтому их проверяют отдельно.
Для систематического знакомства с терминологией и практикой подойдут курсы нейросетей с нуля. Сначала полезно научиться различать данные, модель и оценку результата, затем переходить к более сложным сценариям.
💡 История понятия
В декабре 1943 года Уоррен Маккаллок и Уолтер Питтс описали нервные события средствами логики высказываний. В их рассуждении использовался принцип срабатывания «всё или ничего». Исследователи показали связь логических выражений с поведением таких сетей.
Источник: McCulloch, Pitts, «A logical calculus of the ideas immanent in nervous activity», The Bulletin of Mathematical Biophysics.
Ошибки в объяснениях и шесть вопросов себе
Разговор о нейросетях становится точнее, когда сравнивают одинаковые уровни. Обучение сопоставляют с обучением, устройство модели с архитектурой, а сервис с другими продуктами. Смешение этих уровней создаёт обещания и запреты, которые плохо описывают реальную систему.
Ошибка 1: считать входной текст параметрами сети
Почему так нельзя: контекст передаёт текущую задачу, а веса и смещения определяют вычисления модели. Это разные элементы.
Как не ошибиться: спросите, меняется ли состояние модели при обучении или ей подали новый вход.
Ошибка 2: называть любой ответ поисковой выдачей
Почему так нельзя: генерация текста и получение документов из поиска выполняют разные действия.
Как не ошибиться: посмотрите, подключён ли поиск, какие документы использованы и действительно ли они подтверждают ответ.
Ещё две путаницы относятся к названиям. Глубокое обучение не обозначает человеческую глубину мысли, а искусственный нейрон не содержит биологической клетки. Для объяснения этих слов возвращайтесь к слоям и вычислительным операциям.
Теперь проверьте базовые понятия. Вопросы ниже составлены по статье, а тест после вывода позволит продолжить тренировку. Откройте пояснение после собственного ответа и отметьте термин, который нужно повторить.
1. Яркость пикселя относится к входу или к весу?
Ответ: к входным данным, если модель получает изображение через значения пикселей. Вес — отдельный параметр, влияющий на вычисление.
2. Чему равен выход ReLU при входном значении −3?
Ответ: нулю. ReLU возвращает максимум из нуля и своего входного значения.
3. Сколько значений яркости в картинке MNIST 28 × 28?
Ответ: 784. В этом наборе изображение имеет один канал яркости, а 28 × 28 = 784.
4. Как называется один проход по обучающему набору?
Ответ: эпоха. Вопрос относится к процедуре обучения, а не к числу слоёв или размеру модели.
5. Нейросети и искусственный интеллект имеют одинаковый объём значения?
Ответ: нет. Искусственный интеллект шире; нейронные сети входят в число семейств моделей машинного обучения.
6. Что оценивают в нейронном переводе предложения?
Ответ: сохранение смысла, качество языка и соответствие контексту. Это другой результат, чем выбор метки цифры на изображении.
Вывод
Нейросеть преобразует числовые представления данных с помощью обученных параметров. Устройство определяет архитектура, параметры настраиваются при обучении, а при применении модель получает вход и вычисляет результат. Задачи варьируются от классификации цифр до генерации последовательностей.
Проверьте, как вы запомнили термины, в тесте на понимание нейросетей. Если ошиблись, вернитесь к нужному этапу схемы: так термин будет связан с действием, которое он обозначает.