Искусственный интеллект помогает программе распознавать речь, находить закономерности в данных и создавать новые материалы. Спам-фильтр определяет подозрительное письмо, переводчик подбирает фразу на другом языке, а чат-бот составляет ответ на вопрос. Для таких задач создают разные системы, и ни робот с руками, ни человеческое сознание для их работы не обязательны. Ниже разберём, как устроены такие системы, чему они учатся на примерах и почему даже связный ответ бывает ошибочным.
Что делает систему интеллектуальной?
ИИ называют область исследований и технологии, которые позволяют компьютерам выполнять задачи, связанные с человеческими умственными способностями. Это распознавание образов, работа с языком, рассуждение и поиск решений. В разговоре тем же сокращением обозначают конкретную систему: например, программу для распознавания речи. Значение зависит от контекста.
Согласно определению ОЭСР, система ИИ получает входные данные и выводит из них прогнозы, материалы, рекомендации или решения. Эти результаты могут влиять на цифровую или физическую среду. Одна система только подбирает товары на экране, другая помогает устройству действовать в окружающем мире, причём степень самостоятельности у таких решений различается.
Модель — это математическая конструкция, которая связывает вход с результатом. На вход можно подать запись голоса и получить текст: между ними программа преобразует данные с помощью своих правил и настроек. Модель служит частью системы: отдельно ещё нужны приложение, хранение информации и средства взаимодействия с пользователем.
В глоссарии Санкт-Петербургского политехнического университета ИИ описан через имитацию познавательных функций человека. Такое определение помогает понять назначение технологии. Оно не требует, чтобы программа переживала эмоции или имела биографию собеседника.
| Задача | Как выглядит результат |
|---|---|
| Распознать объект | На фотографии отмечена собака |
| Отнести данные к категории | Письмо попало в папку спама |
| Предсказать число | Получена оценка будущего спроса |
| Подобрать вариант | Показана рекомендация фильма |
| Создать материал | По заданию написан черновик письма |
Обычная автоматизация тоже выполняет работу за человека. Будильник звонит в назначенное время, таблица складывает расходы, калькулятор умножает числа. Чтобы назвать программу ИИ, этих функций недостаточно: существенны способы представления знаний, вывода или обучения, с помощью которых решается задача.
Граница спорная. Экспертная система, например, использует знания специалиста, записанные в виде правил, и относится к классическому направлению ИИ. При этом обучение на каждом новом примере для неё не обязательно, поэтому определение «любая программа, которая сама учится» оказывается слишком узким.
Удобнее смотреть на конкретное действие: что подали программе, какую задачу она решала и что вернула. Название «умная» на коробке отвечает на эти вопросы редко.
Связи между основными понятиями
Машинное обучение входит в область ИИ. Машинное обучение — это подход, при котором модель находят или настраивают по данным. Разработчик задаёт способ обучения и цель, но не выписывает вручную ответ для каждого будущего письма или снимка. Такую связь областей описывают AWS и Международная организация по стандартизации, ISO.
Нейронная сеть — это модель из связанных вычислительных узлов. Каждый узел преобразует числа, а связи передают результат дальше. Название отсылает к нервным клеткам, но искусственная сеть остаётся математической системой. Сравнение с мозгом помогает представить связи, а детали устройства у них существенно различаются.
Глубокое обучение использует нейросети с несколькими слоями преобразований. Один слой получает результат предыдущего и строит следующее представление данных. Например, при обработке изображения модель может выделять всё более сложные сочетания признаков. Для читателя достаточно запомнить вложенность понятий, без изучения устройства каждого слоя.
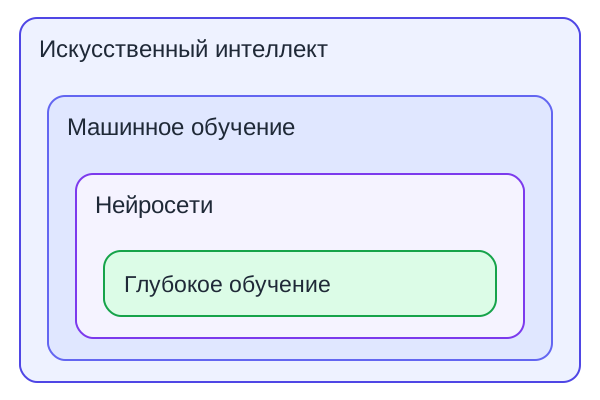
Машинное обучение бывает и без нейросетей. Среди других моделей есть деревья решений: последовательность развилок по признакам объекта. Есть линейные модели, которые связывают результат со взвешенной суммой входных величин. Выбор метода зависит от задачи, объёма данных и требований к результату.
Генеративный ИИ создаёт материалы: текст, звук или изображение, поэтому ставить его в один ряд с «нейросетями» как взаимоисключающие виды неудобно. Одно название говорит об устройстве модели, другое о её назначении.
💡 История понятия
Название artificial intelligence закрепилось в предложении исследовательского проекта от 31 августа 1955 года. Его подписали Джон Маккарти, Марвин Минский, Натаниэль Рочестер и Клод Шеннон. Они предложили провести летний семинар в Дартмутском колледже в 1956 году. Поэтому в истории ИИ встречаются обе даты: документ и сама встреча.
Источник: оригинал «A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence», опубликованный в архиве Джона Маккарти в Стэнфордском университете.
От названия области нельзя вывести способности отдельного продукта. Нейросеть для распознавания речи и модель для создания изображения относятся к одной большой области, но принимают разные данные. Чтобы пользоваться ими осмысленно, нужен ещё один вопрос: как модель получила свои настройки?
Как модель учится на примерах?
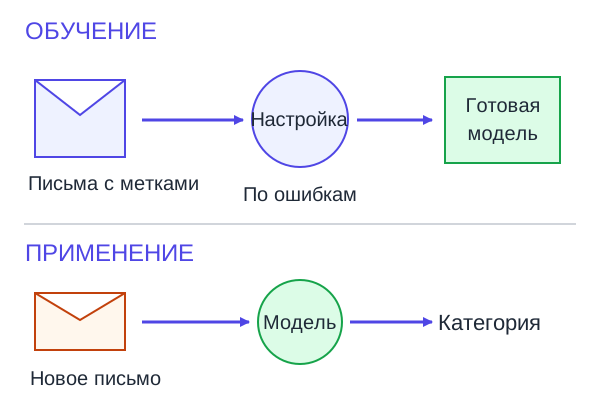
При обучении программа настраивает модель под задачу; если ответы известны заранее, система сравнивает с ними свой результат и меняет настройки. Разница между результатами выражается числом, которое называют ошибкой или функцией потерь. Меньшая ошибка на подходящих проверочных данных обычно говорит о более удачной модели.
Возьмём спам-фильтр: в обучающих письмах уже указано, какие сообщения нежелательные, и модель ищет признаки, связанные с этой отметкой. Такими признаками могут быть особенности текста, отправителя или структуры сообщения. Жёсткое правило «всё со словом скидка отправить в спам» быстро заденет и полезную рассылку магазина.
Курс Google по машинному обучению называет такой способ обучением с учителем. «Учитель» означает наличие правильных ответов в данных: человек не сидит рядом с каждым вычислением и не объясняет компьютеру смысл письма вслух.
- Подготовить примерыСобрать письма и отметки категорий, удалить ненужные повторы и проверить качество данных.
- Настроить модельПолучать предсказания на обучающей части и менять параметры по ошибкам.
- Выбрать настройкиОценить варианты на валидационной части, которую используют для промежуточной проверки.
- Проверить на новых данныхИспользовать отдельную тестовую часть и изучить, какие письма модель путает.
Google отдельно объясняет разделение данных на обучающую, валидационную и тестовую части. Если проверять модель только на знакомых примерах, можно пропустить переобучение, когда результаты на обучении хорошие, а на новых данных заметно хуже. Проверка получается слишком лёгкой.
Есть и другие способы. Обучение без учителя позволяет искать структуру в данных без заранее заданных меток каждого объекта. Например, модель объединяет похожие записи в группы. При обучении с подкреплением система пробует действия и получает оценку результата: вознаграждение, связанное с поставленной целью.
Во время применения, которое также называют выводом модели, уже настроенная система получает новый вход и может выдать прогноз без изменения своих параметров. Некоторые системы продолжают адаптацию после запуска, но это отдельное свойство, а не обязательный спутник каждого ответа.
Различие видно в обычном чате: бот учитывает уточнение и меняет следующий ответ, для чего достаточно передать предыдущую переписку на вход. Изменение ответа ещё не доказывает, что за секунду переобучилась вся модель. Контекст разговора и обучение параметров работают по-разному.
От спам-фильтра до белковой структуры
ИИ давно встречается за пределами разговорных приложений. Сравним четыре системы с понятными результатами. У каждой есть свой вход, задача и способ проверки, благодаря чему слово «интеллект» перестаёт означать одну загадочную способность на все случаи.
Gmail фильтрует нежелательные письма. По информации Google Safety Center, почтовый сервис применяет ИИ для защиты от спама. Пользователь видит итог в папках почты, хотя с моделью никто не разговаривает. Это классификация. Входному объекту назначают категорию.
Вы ждёте письмо с подтверждением, обновляете входящие, а оно уже полчаса сидит в спаме. Фильтр сработал, только не так, как хотелось. На таком случае легко понять цену ложного срабатывания: полезное сообщение приняли за нежелательное, и пользователь остался без нужного подтверждения.
Google Neural Machine Translation переводит предложения. В публикации Google Research 2016 года разработчики описали переход к нейронному переводу, который рассматривает предложение целиком. Такой подход учитывает связи внутри фразы, которые пословный словарь часто теряет, особенно при неоднозначных словах. Соседние слова меняют смысл.
AlphaGo выбирала ходы в го. По данным Google DeepMind, система сочетала глубокие нейросети с поиском вариантов. Обучение началось с партий людей, после чего программа играла с версиями самой себя и постепенно улучшала выбор ходов по результатам этих игр. В марте 2016 года AlphaGo выиграла матч у Ли Седоля со счётом 4:1. Это пример результата в конкретной игре с чёткими правилами победы.
AlphaFold предсказывает пространственную структуру белков. Белок состоит из цепочки аминокислот, которая складывается в объёмную форму. По информации Google DeepMind, важный этап развития AlphaFold связан с международной проверкой методов предсказания структуры белков CASP в 2020 году. Полученная структура помогает исследователям, а достоверность отдельных предсказаний оценивают отдельно от красивого изображения молекулы.
| Система | Что поступает на вход и что получается |
|---|---|
| Спам-фильтр Gmail | Письмо → категория сообщения |
| Нейронный перевод Google | Предложение → перевод с учётом контекста |
| AlphaGo | Положение на доске → выбранный ход |
| AlphaFold | Данные о белке → предсказанная структура |
В этих примерах отличаются и критерии успеха. Для перевода важны сохранение смысла и естественность фразы. Для игры результат задают её правила, для фильтра почты существенны пропущенный спам и ошибочно спрятанные сообщения. Единственная оценка «насколько умный» скроет именно те различия, которые нужны пользователю.
Почему разговор с ботом похож на общение?
Большая языковая модель обучается на закономерностях языка и умеет строить продолжения текста. Сокращение LLM происходит от large language model. Один распространённый способ генерации состоит в последовательном предсказании следующего фрагмента текста с учётом предыдущих. Так получаются ответы, переводы и краткие пересказы.
Фрагменты, которыми оперирует модель, называют токенами. Токеном бывает слово, его часть или отдельный знак, поэтому длина запроса в токенах отличается от количества слов и зависит от способа разбиения текста. Точные правила разбиения зависят от модели.
Согласно учебному материалу Google о LLM, модели Transformer используют механизм внимания для учёта связей между частями текста. Слово «внимание» здесь обозначает вычисление значимости связей. Например, в предложении «Маша убрала книгу в сумку, потому что та мешала на столе» нужно понять, к чему относится «та».
Архитектуру Transformer представили в работе Attention Is All You Need в 2017 году. На удобство диалога влияют также обучение выполнению инструкций и устройство приложения: одной удачной архитектуры недостаточно, чтобы получить готового разговорного помощника.
Вы просите короткое письмо соседям о шумном ремонте, а бот выдаёт речь для торжественного открытия перфоратора. Уточнение «два предложения, спокойный тон, без поздравлений» меняет результат. Модель получает более конкретное описание задачи и меньше пространства для лишних деталей.
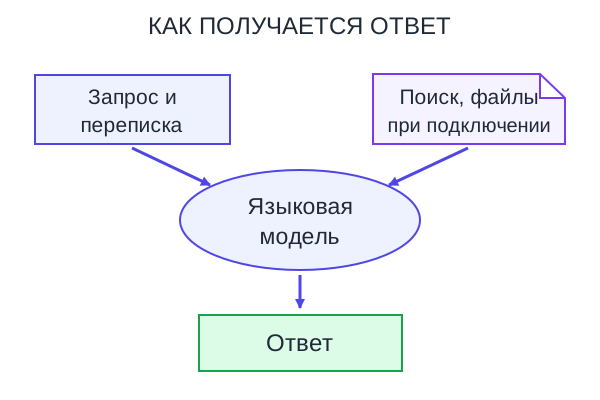
Продукт вокруг модели иногда подключает поиск, базу документов или калькулятор. Тогда ответы могут опираться на свежую найденную информацию и результаты вычислений, если эти возможности предусмотрены в конкретном приложении. Дата обучения модели и доступность поиска не одно и то же.
Здесь полезно различать ответ и действие. Фраза «событие добавлено» в обычном текстовом окне ещё не показывает запись в календаре. Для выполнения операции приложению нужен подключённый инструмент и соответствующие права. Итог можно увидеть в самом календаре или журнале действий.
Гладкая речь делает такой интерфейс привычным. Она позволяет разговаривать с программой обычными фразами, но особенности вычислений от этого не исчезают.
Что означают узкий, общий и генеративный ИИ?
Названия видов ИИ часто отвечают на разные вопросы. «Узкий» и «общий» описывают широту способностей. «Генеративный» говорит о создании материалов. «Автономный» относится к самостоятельности действий. Это разные оси описания. Системе подходят сразу несколько таких признаков.
Узкий, или специализированный, ИИ решает ограниченный круг задач. Система, которая хорошо выбирает ходы в го, не становится от этого переводчиком. При этом специализация может быть широкой внутри своей области: например, приложение работает с разными видами текста.
Общий ИИ, или AGI, связывают со способностью успешно решать широкий круг интеллектуальных задач и переносить навыки между ними. Граница зависит от определения: в работе Google DeepMind «Levels of AGI» отдельно рассматриваются результативность, общность и самостоятельность систем.
В марте 2026 года Google DeepMind представила ещё одну схему измерения продвижения к AGI через познавательные способности. Исследователям нужны проверяемые критерии, поскольку фразу «программа почти как человек» трудно сопоставить с результатами испытаний. Что именно сравнивать?
| Основание классификации | Какие различия описывает |
|---|---|
| Широта способностей | Специализированная задача или широкий набор разных задач |
| Вид результата | Распознавание, прогноз, рекомендация либо генерация |
| Способ обучения | Примеры с ответами, поиск структуры, обучение через вознаграждение |
| Самостоятельность | Подсказка человеку или выполнение разрешённых действий |
В популярных статьях «сильным ИИ» иногда называют общий интеллект. В философии термин связан также с вопросами понимания и сознания. Чтобы избежать путаницы, при таком слове полезно уточнять смысл. Здесь сталкиваются два разных обсуждения: насколько широк круг решаемых задач и есть ли у системы субъективные переживания, которые принято связывать с сознанием.
Генерация текста тоже может сочетаться с прогнозом и классификацией. Один сервис пишет черновик, определяет тему обращения и передаёт его в нужный отдел. За каждой функцией может стоять своя модель.
Для повседневного использования классификация нужна как карта свойств. Выбираете переводчик — проверяете перевод, а не наличие красивого обещания об общем интеллекте.
Ошибки, которые звучат убедительно
Система ИИ может ошибаться при распознавании, прогнозе и генерации. Причины различаются: неподходящие данные, недостаточная информация, изменение условий или особенности метода. У разговорных моделей заметен отдельный риск: неверное утверждение подаётся связной фразой, без внешних признаков сомнения.
NIST, американский институт стандартов и технологий, называет создание ложных или вводящих в заблуждение материалов конфабуляцией. В разговоре распространено слово «галлюцинация». В профиле рисков генеративного ИИ NIST объясняет, что статистическое построение ответа способно порождать фактические ошибки и внутренние противоречия.
Особенно неприятна выдуманная ссылка: название статьи выглядит правдоподобно, фамилия автора тоже, но по указанному адресу нужной публикации нет. Проверять нечего. Просьба «добавь источники» полезна как начало проверки, но сам список ещё предстоит открыть и прочитать.
Ошибка 1: принять уверенную формулировку за доказательство
Почему так нельзя: правдоподобный ответ может содержать выдуманную дату, цитату или источник.
Как не ошибиться: открыть первоисточник и найти в нём утверждение, которое собираетесь использовать.
Ошибка 2: оценивать качество только по знакомым примерам
Почему так нельзя: удачные ответы на нескольких выбранных вопросах скрывают слабые места в других условиях.
Как не ошибиться: добавить новые и неоднозначные случаи, затем разобрать типы ошибок.
Другой риск связан с предвзятостью: система может систематически хуже работать для некоторых групп или условий. Например, состав данных влияет на качество распознавания. NIST относит вредную предвзятость к отдельным рискам генеративных систем, поэтому при оценке существенно, для кого и где собираются применять модель.
Для спам-фильтра меняется и сама среда. Отправители нежелательных писем придумывают новые формулировки, а полезные рассылки меняют оформление. Модель, проверенная на старой почте, нуждается в оценке на актуальных сообщениях. Это уже вопрос наблюдения за системой после запуска.
Критичные решения о здоровье, деньгах или правах человека требуют профессиональной оценки и подходящих процедур контроля. Полезные задачи для обычного чат-бота проще: предложить вопросы к специалисту, организовать ваши заметки, подготовить черновик. Финальное решение зависит от фактов и обстоятельств конкретного случая.
Как попробовать ИИ на своей задаче?
Для первой попытки выбирайте задачу с проверяемым результатом. Подойдут сокращение собственного текста, подготовка вопросов для встречи или объяснение знакомого правила. Заранее назовите обязательные факты и требуемый объём, чтобы затем оценить, что сохранилось в результате и не добавилось ли лишнее.
Разговор с ботом удобно начать с материала, который вам уже понятен. Например, у вас есть длинная инструкция для гостей. Попросите сделать короткую версию, сохранив время приезда и порядок получения ключей. Время приезда потерялось? Такой вариант отправлять рано.
- Назовите результат«Сократи инструкцию для гостей до одного абзаца». Это точнее просьбы «сделай красиво».
- Дайте нужный материалПриложите исходный текст и перечислите факты, которые требуется сохранить. Используйте общедоступные сведения.
- Укажите ограниченияНазовите объём, адресата и тон. Попросите отмечать отсутствующие сведения вместо заполнения пробелов догадками.
- Сопоставьте версииПроверьте, что сохранились обязательные детали и текст подходит получателю. При необходимости уточните задание.
Вы просите поздравление для бабушки, а получаете обращение к «уважаемому партнёру». Попробуйте уточнить, кому адресован текст и как вы обычно обращаетесь к этому человеку, чтобы бот мог выдержать более подходящий тон. Личные подробности для такой правки не нужны.
Не загружайте в случайный сервис чужие документы, рабочие секреты и личную переписку. Правила хранения и использования запросов различаются. Для знакомства достаточно открытого материала или самостоятельно составленного текста без чувствительных сведений.
Попробовать разговорный формат можно через раздел AI-чат-ботов. У каждого приложения отдельно посмотрите доступные функции: поиск, загрузка файлов, работа со звуком. Наличие нужной функции важнее общего названия технологии.
Если хочется последовательно освоить работу с такими инструментами, подойдёт раздел «Нейросети с нуля». Переходить к занятиям разумно после первой собственной задачи: уже будет понятно, какого навыка не хватает.
Здесь речь об основах устройства ИИ. Выбор корпоративных процессов, бюджет и оценка внедрения относятся к другому вопросу; они разобраны в материале об ИИ для бизнеса.
Проверьте, что осталось в памяти
Четыре коротких задания помогают различить понятия без сложных формул. Сначала выберите ответ самостоятельно, затем раскройте объяснение. Если возникло сомнение, вернитесь к примеру, на котором строился вопрос: письмо, диалог или игровая система.
1. Спам-фильтр обработал новое письмо. Обязательно ли в этот момент шло обучение?
Ответ: нет. Уже обученная модель может назначить письму категорию без изменения своих параметров.
2. Можно ли назвать генератор изображений нейросетью и генеративным ИИ одновременно?
Ответ: да, если генератор построен на нейросетевой модели. «Нейросеть» описывает устройство, «генеративный» обозначает создание нового материала.
3. Что лучше показывает способность модели обобщать: знакомые примеры или отдельная тестовая часть?
Ответ: отдельная тестовая часть без пересечения с обучающей. Она помогает оценить работу на ранее не использованных примерах.
4. Победа в го доказывает способность программы переводить книги?
Ответ: нет. Результат показывает успех в игре. Для перевода нужны соответствующие возможности и отдельная оценка.
После этих вопросов полезно пройти тест на понимание нейросетей. В нём 20 заданий об обучении, архитектурах и применении, а у ответов есть объяснения. Ошибка в тесте подскажет, к какой теме вернуться, без необходимости перечитывать всё подряд.
Вывод
ИИ охватывает разные способы работы с данными и знаниями: от классификации писем до создания новых материалов. Обучение модели и её применение составляют два разных этапа. Для собственной практики выбирайте результат, который можете проверить: так знакомство с технологией превращается в освоенный навык.